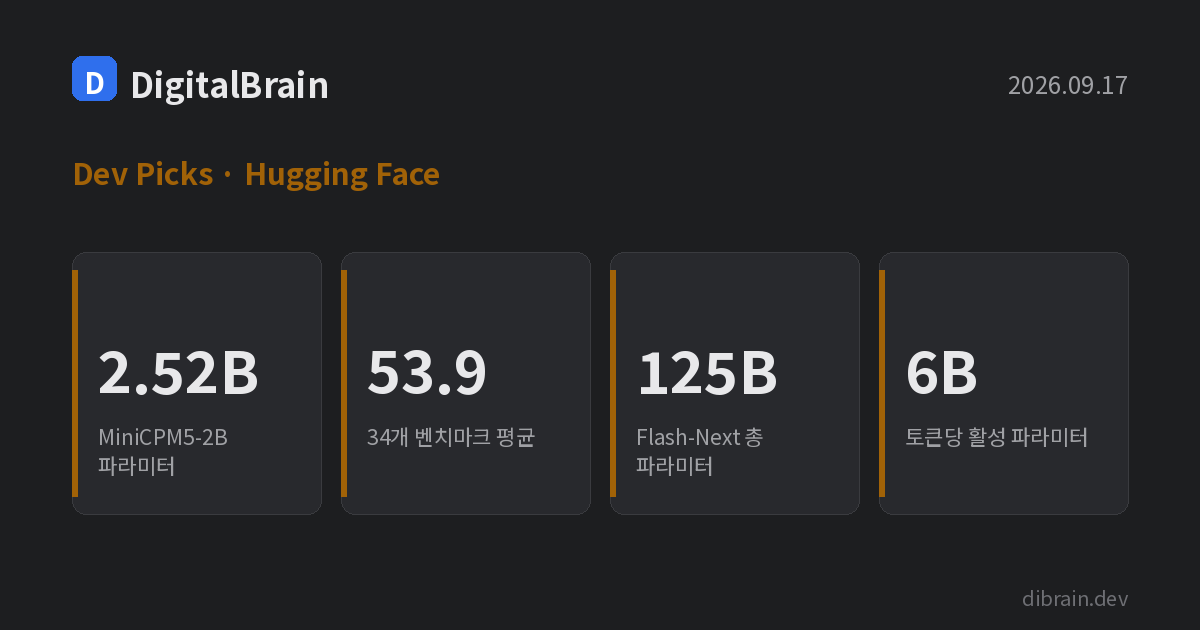
이번 주 Hugging Face 트렌딩은 방향이 정반대인 모델 두 개로 갈렸습니다. 하나는 몸집을 줄여서 이기려 하고, 다른 하나는 몸집은 그대로 두되 쓰는 부분만 줄였습니다.
MiniCPM5-2B
- 모델 카드: openbmb/MiniCPM5-2B
- 소스: GitHub - OpenBMB/MiniCPM
- 제작: OpenBMB
- 라이선스: Apache-2.0
- 파라미터: 2.52B (dense), 42레이어, GQA(쿼리 헤드 16 · KV 헤드 2)
- 컨텍스트: 131,072 토큰
- 공개일: 2026-09-07
MiniCPM5 시리즈의 두 번째 체크포인트로, 클라우드가 아니라 로컬·온디바이스 실행을 목표로 설계됐습니다. OpenBMB가 공개한 34개 벤치마크 평균은 53.9점으로, 더 큰 Qwen3.5-4B(51.1점)를 앞섭니다. MATH-500 94.6, SWE-bench Verified 46.4을 기록했습니다(OpenBMB 자체 발표 수치). 공개 당일부터 GGUF, MLX, GPTQ, 모바일용 LiteRT 포맷을 함께 내놓아 휴대폰급 기기에서도 바로 써 볼 수 있습니다.
실행 예시(transformers):
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "openbmb/MiniCPM5-2B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, device_map="auto")
inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "Who are you?"}],
    add_generation_prompt=True, return_tensors="pt"
).to(model.device)
outputs = model.generate(inputs, max_new_tokens=128)
print(tokenizer.decode(outputs[0]))
Ollama, llama.cpp, LM Studio, vLLM에서도 바로 돌아갑니다. 추천 대상: 서버 비용 없이 로컬에서 코딩·에이전트 작업을 돌려보고 싶은 개발자.
Qwen3.8-Flash-Next
- 모델 카드: Qwen/Qwen3.8-Flash-Next
- GGUF: unsloth/Qwen3.8-Flash-Next-GGUF
- 제작: Qwen Team, Alibaba Group
- 라이선스: Qwen Community License 1.0 (대형 서비스·MaaS 사업은 별도 라이선스 필요. Apache-2.0 아님)
- 파라미터: 출처마다 다릅니다 — Qwen 공식은 총 125B(토큰당 활성 6B)에 51B n-gram 임베딩·4B MTP 레이어를 별도로 둔다고 설명하고, 일부 3rd-party 글은 합쳐서 총 177B로 계산합니다. 확인 필요.
- 컨텍스트: 262,144 토큰
- 태스크: 멀티모달(텍스트+비전) MoE
- 공개일: 2026-08-26
Qwen4 아키텍처의 첫 오픈 웨이트 미리보기입니다. Gated DeltaNet 레이어 3개와 Qwen Sparse Attention(QSA) 블록 1개를 반복하는 하이브리드 구조로, QSA는 토큰이 아닌 마이크로블록 단위로 동작해 긴 컨텍스트 지연을 줄입니다. 커뮤니티 GGUF 양자화판은 4비트 기준 약 82GB로, 통합 메모리 75GB 이상이면 디스크리트 GPU 없이 돌아갑니다. 64GB M5 Max 맥에서 비전 입력 포함 초당 36토큰이 나왔다는 커뮤니티 보고도 있습니다(3rd-party, 공식 수치 아님). 휴대폰이 아니라 고사양 워크스테이션급 온디바이스로 봐야 합니다.
실행 예시(vLLM):
vllm serve Qwen/Qwen3.8-Flash-Next --port 8000 --tensor-parallel-size 4
GGUF는 llama.cpp에서 바로 로드됩니다. 추천 대상: 대용량 통합 메모리 맥이나 멀티 GPU 서버로 차기 Qwen4 아키텍처를 미리 만져보고 싶은 개발자.
오늘의 정리
두 모델은 “온디바이스"를 다른 방식으로 풉니다. MiniCPM5-2B는 파라미터를 2.52B까지 줄여 휴대폰까지 내려가고, Qwen3.8-Flash-Next는 총량 125B에 활성 파라미터만 6B로 묶어 고사양 맥·워크스테이션을 겨냥합니다. 가벼운 로컬 모델은 MiniCPM5-2B, 차기 아키텍처 미리보기는 Qwen3.8-Flash-Next 쪽입니다.